
透過特徵工程將連續變數離散化切箱,並繪製「雙因子交互作用熱力圖(Interaction Heatmap)」與「多維度散佈圖」,清楚解鎖作息與用眼的交互影響。
一、實作前情境:單因子看不出端倪,複合因子才見真章?
在前面的分析中,我們發現了兩個耐人尋味的統計事實:
然而在生理醫學與臨床經驗中,「睡眠不足」常被視為降低人體自我修復能力的元凶。
當睫狀肌經過整日高強度螢幕注視後,若夜晚睡眠充足,眼球表面微血管與淚膜屏障通常能獲得一定程度的恢復;反之,若在「長時間螢幕暴露」的同時又伴隨「嚴重睡眠剝奪」,是否才會觸發顯著的疼痛與疲勞閥值?
這就是典型的交互作用。今天我們利用資料切箱技術,將受試者劃分成不同作息矩陣,探討這兩大生活因子組合下的真實症狀走勢。
二、撰寫多變數交互作用視覺化腳本
在Colab中新增儲存格,建立資料切箱分組,並繪製雙因子交互作用熱力圖:
# ==========================================
# Day 13:交互作用熱力圖
# ==========================================

import warnings
warnings.filterwarnings('ignore') # 徹底靜音 Matplotlib 內部的字型量測警告

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd
import numpy as np

# 1. 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 2. 特徵工程:分箱切片 (Binning)
df['Screen_Group'] = pd.cut(
    df['Daily_Screen_Hours'],
    bins=[0, 6, 10, 16],
    labels=['輕度暴露 (<6h)', '中度暴露 (6-10h)', '重度暴露 (>10h)']
)

df['Sleep_Group'] = pd.cut(
    df['Sleep_Hours'],
    bins=[0, 5, 7, 12],
    labels=['睡眠不足 (≤5h)', '睡眠適中 (5-7h)', '睡眠充足 (>7h)']
)

# 3. 樞紐分析(observed=False 消除警告)
pivot_dryness = df.pivot_table(
    index='Sleep_Group',
    columns='Screen_Group',
    values='Eye_Dryness_Level',
    aggfunc='mean',
    observed=False
)

pivot_pain = df.pivot_table(
    index='Sleep_Group',
    columns='Screen_Group',
    values='Eye_Pain_Level',
    aggfunc='mean',
    observed=False
)

# 4. 繪製 1x2 交互作用熱力圖
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="white")

# --- 圖 1:乾澀程度交互影響 ---
ax1 = sns.heatmap(
    pivot_dryness,
    annot=True,
    fmt=".2f",
    cmap='YlGnBu',
    cbar_kws={'label': '平均乾澀分數 (0-10)'},
    ax=axes[0]
)
axes[0].set_title('睡眠時數 × 螢幕時數 對 眼睛乾澀 的交互影響', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[0].set_xlabel('螢幕使用時數分組', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('每日睡眠長度分組', fontproperties=my_font, fontsize=12)
axes[0].set_xticklabels(axes[0].get_xticklabels(), fontproperties=my_font, fontsize=11)
axes[0].set_yticklabels(axes[0].get_yticklabels(), fontproperties=my_font, fontsize=11)
ax1.collections[0].colorbar.set_label('平均乾澀分數 (0-10)', fontproperties=my_font, fontsize=11)

# --- 圖 2:眼痛程度交互影響 ---
ax2 = sns.heatmap(
    pivot_pain,
    annot=True,
    fmt=".2f",
    cmap='OrRd',
    cbar_kws={'label': '平均眼痛分數 (0-10)'},
    ax=axes[1]
)
axes[1].set_title('睡眠時數 × 螢幕時數 對 眼痛程度 的交互影響', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[1].set_xlabel('螢幕使用時數分組', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('每日睡眠長度分組', fontproperties=my_font, fontsize=12)
axes[1].set_xticklabels(axes[1].get_xticklabels(), fontproperties=my_font, fontsize=11)
axes[1].set_yticklabels(axes[1].get_yticklabels(), fontproperties=my_font, fontsize=11)
ax2.collections[0].colorbar.set_label('平均眼痛分數 (0-10)', fontproperties=my_font, fontsize=11)

plt.tight_layout()
plt.show()

# 5. 輸出 9 宮格樣本分佈
sample_counts = df.pivot_table(
    index='Sleep_Group',
    columns='Screen_Group',
    values='Age',
    aggfunc='count',
    observed=False
)
print("=== 9 宮格交叉樣本數分佈表 ===")
display(sample_counts)
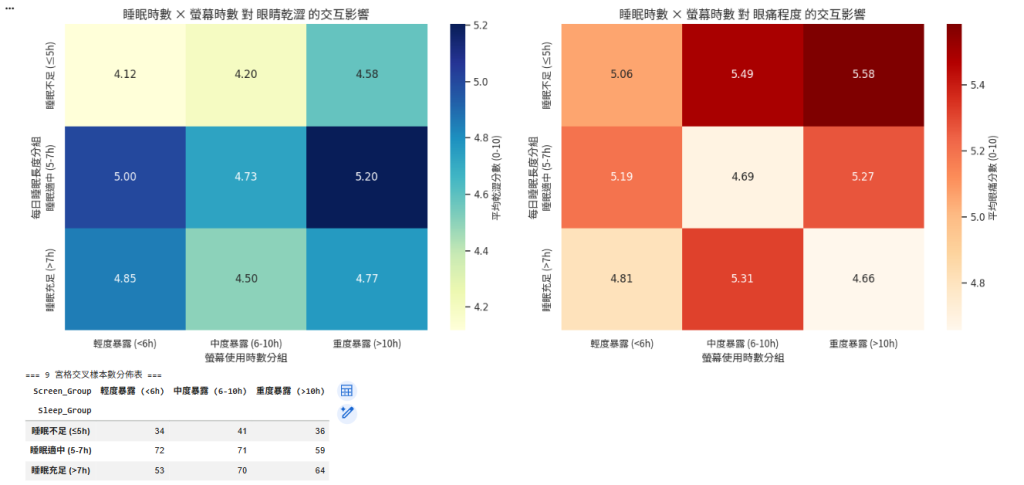
三、圖表解讀與客觀數據分析(正式定稿)
本實作透過 pd.cut 將連續數值離散化為「3×3九宮格作息矩陣」,成功揭示了單一特徵線性分析無法捕捉的多變數交互作用:


 iThome鐵人賽
 看影片追技術